 NexBrowser指纹浏览器-官方博客Blog
刚在搜索框里敲下「AI浏览器自动化」时,绝大多数人都会被迎面扑来的一堆新名词砸晕:Perplexity Comet、Kimi 扩展、Playwright MCP、Chrome DevTools MCP、CLI Skill、Browser Use、云端浏览器、指纹浏览器……
先把结论放最前面:没有通吃一切的 AI 浏览器自动化工具,选错路线才是又慢、又贵、还老断线的根源。 你可以直接按手头任务对号入座:
- 个人查资料、跨网页比价、总结内容:直接用内置 AI 助手的浏览器或浏览器扩展,不用配置代码和协议。
- 开发自测、前端修 Bug、单账号偶尔跑个任务:用 Claude Code、Codex 或 Cursor 接 Playwright MCP / Chrome DevTools MCP 或命令行工具(如
playwright-cli、agent-browser)。 - 需要登录后台、怕触发风控、要多账号并行或团队交接:千万别用日常主力浏览器硬跑,也别每次拉起空白无头实例重登录,而要选择带环境隔离、可持久化保存登录态的浏览器工作台(比如 NexBrowser 内置 AI Agent,或用它的 Local API / MCP 接管独立环境),并配合「AI 探路 + 脚本固化」压低 Token 成本。
下面把 4 类方案的边界、常见踩坑点和低成本落地流程一次讲透。
一、先把 4 类 AI 浏览器自动化路线分清
很多人一上来就对比参数,却忽略了这些工具从底层解决的根本不是同一个问题。甚至在 2026 年,像早期主打通用包办的 ChatGPT Atlas 也经历了退场,行业已经明确分化成四条路线:
| 路线分类 | 典型代表 | 核心强项 | 登录态与风控表现 | 成本与适用边界 |
|---|---|---|---|---|
| AI 浏览器 / 浏览器扩展 | Perplexity Comet、Fellou、Sigma、Kimi/Claude 扩展 | 开箱即用,侧边栏对话就能读页面、总结、辅助填表 | 依赖当前浏览器会话;多账号切换难,扩展权限大时有隐私与误操作风险 | 适合个人日常提效;多数封闭产品外部 Coding Agent 接不进去,不适合批量业务 |
| Coding Agent 接口(MCP / CLI) | Playwright MCP、Chrome DevTools MCP、playwright-cli、agent-browser | 让 Claude Code / Cursor 直接看 DOM、查控制台、点页面 | 默认常拉起临时空白实例,缺少历史 Cookie 且易带自动化特征 | 工具免费,只付模型 Token;适合开发调试,不适合强风控或需要长期养号的业务 |
| AI 自动化框架 / 云浏览器 | Browser Use、Stagehand、Skyvern、Browserbase、Steel | 可写代码定制多步自主任务,或直接上云端高并发运行 | 开源本地版易触发验证码;云端托管自带反检测但需把账密和会话放到第三方 | 开发自由度高;既要付模型 Token,又要算云浏览器时长或按页计费 |
| 隔离环境工作台 + Agent/API | NexBrowser(内置 Agent + Local API / MCP + RPA) | 每个账号独立环境、指纹与代理;既能自然语言指挥,也能给外部框架接管 | Cookie 与本地存储按环境持久化保存,指纹与代理出口对齐,避免反复登录触发风控 | 适合跨境电商、社媒矩阵、广告投放、需要登录后台的采录与多账号团队协作 |
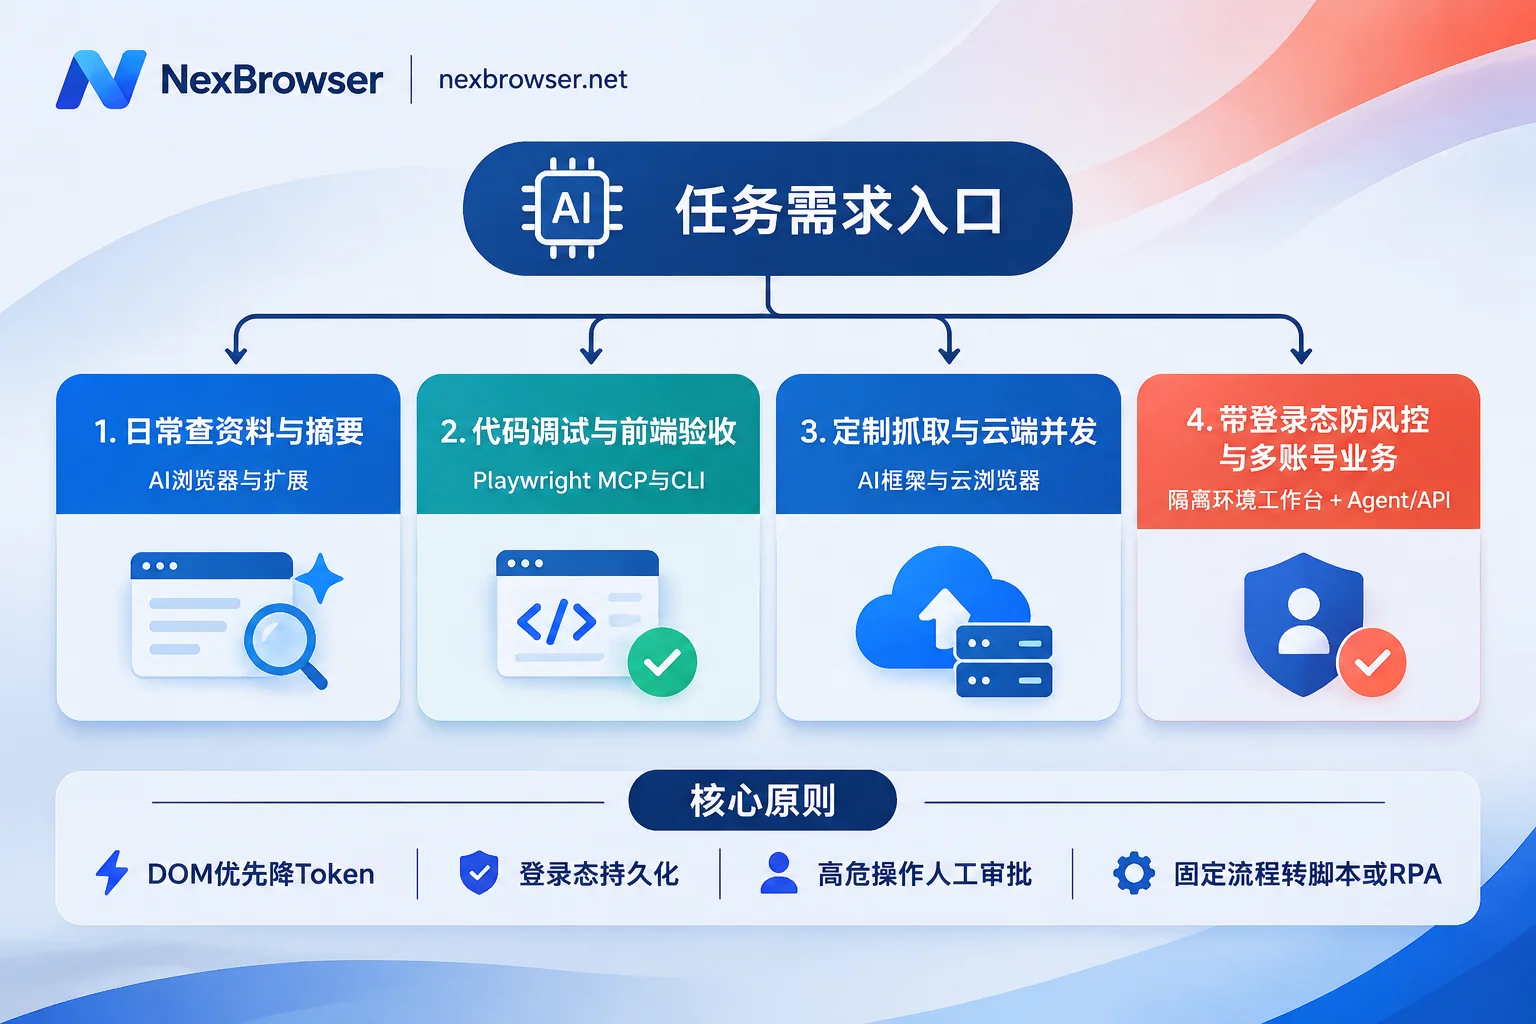
记住一条选型铁律:公开页面读取、前端自测看重「快和省」;一旦涉及「自己的业务账号、反复登录、多人协同」,浏览器底座的隔离性与登录态持久化比模型本身更决定成败。
二、为什么演示很丝滑,自己一跑就“慢、贵、还老断”?
很多人照着教程跑通了第一个 Demo,一放到真实业务里就翻车,问题通常出在以下四个地方。
1. 全程靠“截图 + 视觉模型”硬看,Token 和时间双爆炸
AI 操作网页主要有两种“看页面”的方式:一种是读取 DOM 结构 / 无障碍树,另一种是整页截图喂给多模态视觉模型。
如果所有步骤都依赖整页截图,每走一步都要上传一张高清图并等待模型推理坐标,单步延迟往往在 3 到 10 秒之间。更隐蔽的账单陷阱在于上下文滚雪球:很多 Agent 每推进一小步,就把历史网页快照和前几轮截图再打包发给模型重算一遍,一个十几步的表单任务跑下来,消耗的 Token 可能是纯 DOM 方案的数倍甚至十倍。
避坑做法:优先用基于 DOM 或无障碍树的定位方式(如 Playwright MCP、结构化元素提取),只在遇到 Canvas 图表、Shadow DOM 或高度动态渲染的弹窗时,才回退到视觉截图。
2. 每次启动都是“空白新窗口”,卡死在登录与风控里
用传统脚本或默认 MCP 启动浏览器时,拉起的往往是一个刚出厂般的干净实例:没有历史 Cookie、没有本地存储(IndexedDB)、navigator.webdriver 标记暴露、WebRTC 或时区语言和代理出口对不上。
结果就是:AI 每次干活前都得重新走一遍输入账密、收短信、过滑块验证码的流程,轻则流程中断,重则直接触发平台异常锁定。
避坑做法:自动化绝不能跑在“用完即焚”的空环境里,登录态必须按账号长期留存,并保持浏览器指纹与网络出口一致。
3. 直接把日常主力 Chrome 交给 AI,省事却埋了安全雷区
既然新窗口没登录态,有些人干脆让插件或调试端口直接接管自己每天办公的 Chrome。这马上会带来两个麻烦:
- 人机抢焦点:AI 正在后台点页面,你顺手切了个标签页或动了鼠标,脚本定位当场跑偏。
- 越权与误操作风险:主力浏览器里通常同时登着邮箱、支付后台、社媒主号和公司内部系统。一旦网页里夹带恶意提示词注入,或者模型理解产生偏差,误发消息、误删数据甚至误付款的代价极高。
避坑做法:严格遵循最小权限原则——给 AI 单独开出隔离的浏览器环境,只登录当前任务需要的网站,并在提交订单、发帖、转账等不可逆动作前加上人工批准。
4. 把 AI 当固定脚本用,每天重复的活次次让模型“现场思考”
大模型最擅长的是处理不确定性(比如第一次进一个陌生后台、按钮文案突然改版)。如果一个固定后台每天要录入 50 次数据、路径一成不变,每次还让 AI 从头看一遍页面、推理一遍点哪里,不仅白烧 Token,还可能因为某一步偶发幻觉点错菜单。
避坑做法:用 AI 探路,用确定性流程跑量。 先让 AI 跑通一两次陌生流程、摸清页面结构,一旦路径固定下来,就沉淀成固定脚本或无代码 RPA 批量执行。
三、需要登录态、防风控或多账号时,怎么低成本跑通?
如果你的任务只是抓取公开网页,用 agent-browser 或抓取 API 就够了;但如果你的场景涉及电商店铺后台、社媒矩阵发布、广告账户巡检、或必须先登录才能操作的供应商门户,更稳妥的做法是把“浏览器环境隔离层”和“AI 决策层”拆开配置。
以 AI浏览器自动化 场景下常用的 NexBrowser(基于 Chrome 内核的多账号工作台,目前提供 Windows 10/11 64 位客户端,免费档全功能可用)为例,可以把前面踩的坑用三步收口:
第 1 步:先把“登录态与环境一致性”垫稳
在启动自动化之前,先在 NexBrowser 里为每个业务账号建好独立环境:
- 数据物理级隔离:每个环境的 Cookie、缓存、本地存储(含 IndexedDB)和代理互不串流,不会因为 AI 操作一个号把另一个号挤下线或连坐。
- 启动前先过出口校验:给环境绑定 HTTP / HTTPS / SOCKS5 或关联住宅 IP 后,环境启动前会自动检测代理连通性与出口归属,检测不通过不启动;WebRTC、时区、语言随出口自动对齐,避免“代理连上了但环境穿帮”。
- 登录态长期续接:人工首次登录好目标平台后,关闭环境时数据可加密同步到云端(窗口内自存密码仅留在本机),下次不管是人点开还是 AI 启动,登录态直接续上,不用每次重过验证。
第 2 步:按自己的技术栈,选“内置 Agent”或“接管外部 Agent”
环境备好后,操作层不用被某一家绑定,两条路都能直接跑:
- 不想写代码、快速跑通任务(用内置 Nex Agent):直接在客户端里用自然语言下达任务指令,Nex Agent 会自己打开对应环境、识别页面、填表或截图,也支持把任务拆到多个窗口并行执行。关键的是,你可以设定在执行不可逆操作前先请求批准,跑完后还能全程回看操作记录,防止 AI 擅自下单或误发内容。内置 Agent 的模型调用按 Token 计费,直接用账户余额按量购买即可(可选模型与 Token 单价以官网实时口径为准)。
- 已经在用 Claude Code、Codex、Cursor 或自研脚本(用 Local API + MCP):在客户端打开 OpenAPI,Local API 对免费档同样开放、不限调用次数。你可以用它创建或启动指定环境并读取 CDP 连接信息,直接让 Playwright、Puppeteer、Selenium、browser-use 或 Playwright MCP 接管已经带好指纹和登录态的真实窗口;也可以直接接入 NexBrowser MCP Server,让编码 Agent 列出环境并直接操作页面。具体接法可以直接对照 Local API 加 CDP 与 MCP 直连实战指南 和 browser-use 与 Playwright MCP 接管教程。
第 3 步:跑顺之后做“成本分流”
不要把所有动作都压在 AI Token 上:
- 临时判断、偶发改版的页面:交给 Nex Agent 或 MCP 客户端处理。
- 需要人工临场看一眼的批量微调:用 NexBrowser 的窗口同步,主窗口点一下,其余带独立指纹和代理的从窗口同步跟进。
- 完全固定的重复动作(比如每天固定路径登后台导报表):转到 NexBrowser 的 RPA 脚本(Beta)无代码画布上拖好变量、条件与失败重试,一套脚本绑定一批环境跑,执行日志精确到每个环境的每一步,直接把后续重复执行的 Token 成本降到接近于零。
关于这几种自动化能力在日常业务里的精细配合,也可以参考内置 AI Agent、RPA 与窗口同步的实战分工。
四、上线前 5 项自检清单
准备把任务交给 AI 跑之前,花 1 分钟对照下面 5 条,能省掉 80% 的返工和冤枉钱:
- 这个网站需要长期保留登录态或防关联吗? 如果需要,别用临时无头浏览器,先做独立环境与代理隔离。
- 能用 DOM / 无障碍树解决吗? 只要页面有清晰的 HTML 结构,就别全程开高清截图让视觉模型硬猜。
- 有没有给高危动作加“刹车”? 凡涉及付款、删号、公开发布、改密码的步骤,务必设置人工审批确认,且不要在 AI 环境里登录网银或无关主号。
- 单轮历史信息是否过长? 多步任务定期总结或清理无效快照,避免每一轮都把前十几页的源码和截图重复喂给大模型。
- 这条路径以后还要天天跑吗? 跑通第 1 遍靠 AI 省事,从第 3 遍开始尽量沉淀成 Playwright 脚本或无代码 RPA,让 AI 只负责“探路和兜底”。
如果你想先零成本测一遍“隔离环境 + AI 自动操作”的完整链路,可以先从官网免费档开一个独立环境,开启 Local API 或直接试用内置 Agent 跑通第一条真实工作流再逐步扩容。