 NexBrowser指纹浏览器-官方博客Blog
整条链路只有五步:确认本机接口服务在跑 → 带环境 ID 调启动接口 → 从返回的 JSON 里取调试端口和 WebSocket 地址 → 用这个地址让自动化框架连上去 → 用完调停止接口回收进程。难点不在写请求,而在两个容易翻车的细节:端口是每次启动动态分配的,不能缓存;接口返回成功不等于内核已经能接受连接。
下面按动手顺序展开。
先确认接口服务在哪、能不能通
Local API 不是云端 API,它是客户端在本机开的一个 HTTP 服务,默认监听回环地址(127.0.0.1)。这意味着三件事:
- 客户端必须处于运行状态,脚本才调得通;客户端关了,接口也就没了。
- 请求地址不能换成公网域名或局域网 IP 去调。要让另一台机器触发,正确做法是把脚本放到装客户端的那台机器上跑,或者在那台机器上做本地转发,而不是把接口暴露出去。
- 监听端口以客户端设置界面里显示的为准。不同产品的默认端口和路由前缀并不统一,抄别家文档里的端口号大概率直接连不上。
动手前先做一次连通性自检:在浏览器里或用 curl 请求一下客户端给出的接口地址(很多客户端提供 status 或健康检查类的路由)。这一步通了,后面所有失败才能确定不是服务没开的问题。如果客户端有 API 开关或 API Key,也在这里一并打开、复制好密钥。
启动接口要传什么
启动请求通常是 GET 或 POST,必填的只有一个:目标环境的唯一 ID。不同产品里它叫 profile_id、user_id 或 env_id,值可以从客户端的环境列表里复制,也可以先调环境列表接口按备注名筛出来——后者更适合批量脚本,避免把一串 ID 硬编码进代码。
可选参数按需要加,常见的有:
- 无头模式开关:跑纯数据采集类任务时打开,需要人工介入或调试时关掉。
- 启动后自动打开的页面:调试期可以让它直接打开一个指纹/IP 检测页,肉眼确认环境起对了。
- 窗口尺寸、是否加载扩展等启动参数。
import requests

BASE = "http://127.0.0.1:<客户端设置里显示的端口>"

resp = requests.get(f"{BASE}/<客户端文档给出的启动路由>",
                    params={"user_id": PROFILE_ID})
data = resp.json()
路由路径和字段名请以你所用客户端的接口文档为准,本文只约定结构。
返回里哪几个字段有用
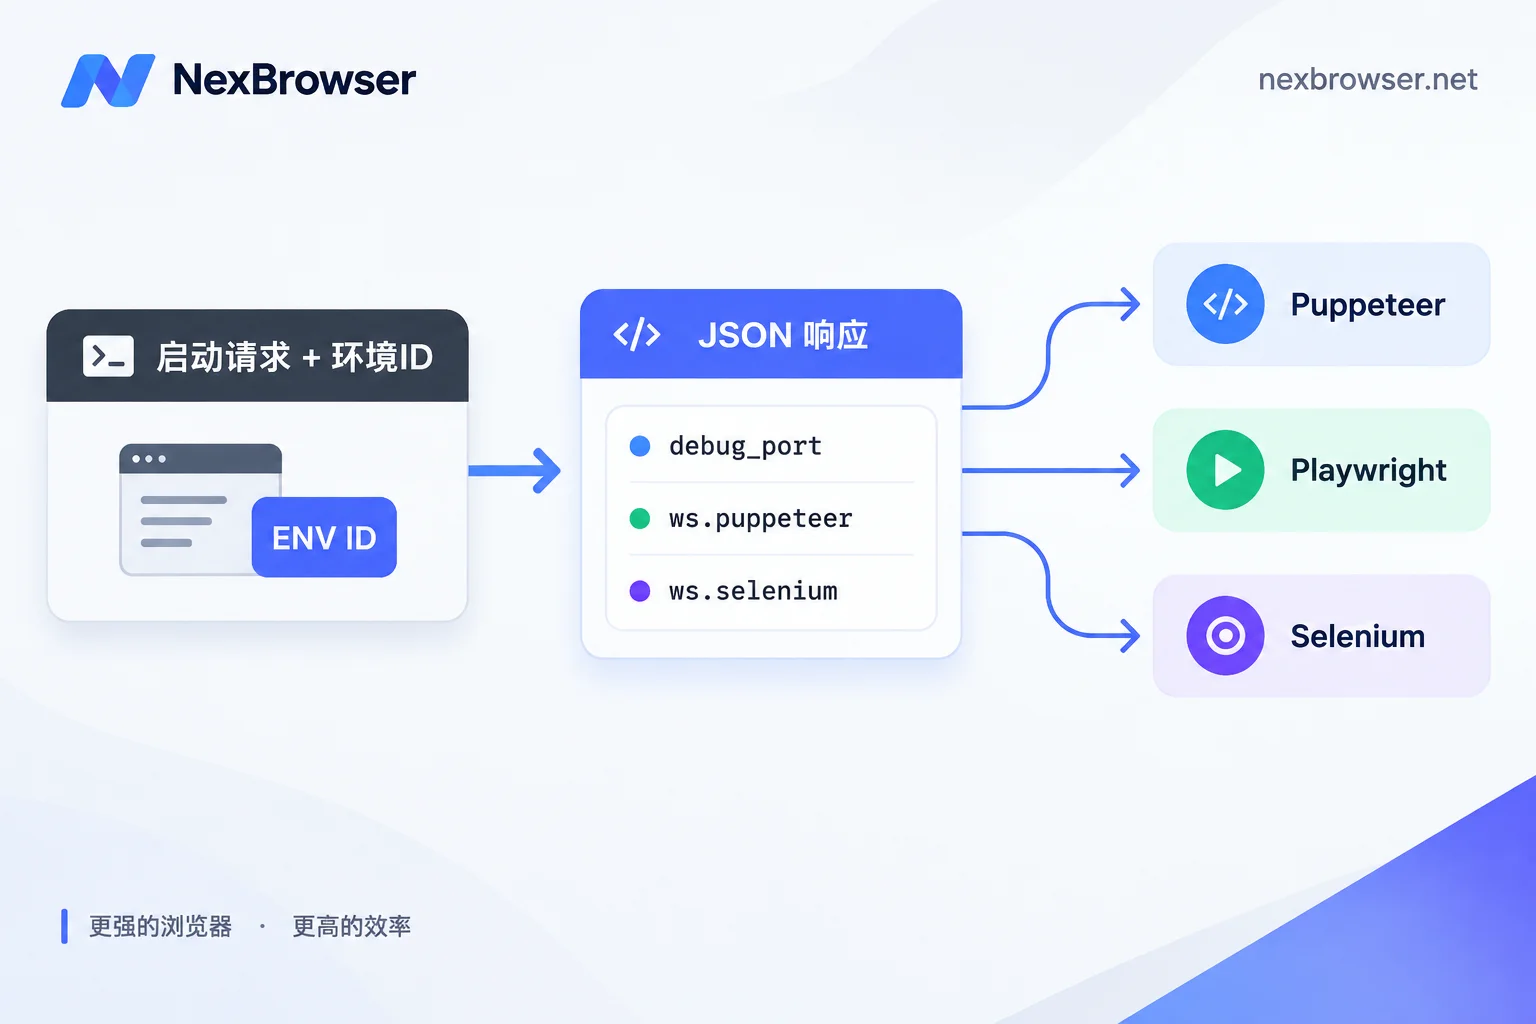
启动成功后返回的 JSON,核心是调试连接信息,通常包含三类值:
debug_port:Chromium 的 CDP 调试端口号,比如50123。ws.puppeteer:完整的 WebSocket 调试地址,形如ws://127.0.0.1:50123/devtools/browser/xxxxxxxx。ws.selenium:形如127.0.0.1:50123的 debuggerAddress 字符串。
部分客户端还会返回与当前内核版本匹配的 webdriver 可执行文件路径,用 Selenium 时优先用它,能省掉 chromedriver 版本对不上的一堆报错。
这三个值每次启动都会变。 端口由系统动态分配,WebSocket 地址里的 browser ID 也是每个进程一份。把上次跑通的端口写死在配置里,下一次要么连到空端口报错,要么更糟——连到另一个环境的实例上,用 A 账号的浏览器执行了 B 账号的脚本。所以流程必须是:每次启动 → 解析响应 → 用本次返回的地址连接。
三个框架分别怎么接
Puppeteer 用 connect,传 WebSocket 端点:
const browser = await puppeteer.connect({
  browserWSEndpoint: wsEndpoint,
  defaultViewport: null,   // 别让 Puppeteer 覆盖环境自带的窗口尺寸
});
const pages = await browser.pages();
const page = pages[0] || await browser.newPage();
defaultViewport: null 这一项建议保留。默认值会把视口改成 800×600,而视口尺寸和环境配置的屏幕参数是要对得上的。
Playwright 用 connectOverCDP,传 ws 地址或 http://127.0.0.1:{debug_port} 都行:
const browser = await chromium.connectOverCDP(`http://127.0.0.1:${debugPort}`);
const context = browser.contexts()[0];          // 用已有上下文
const page = context.pages()[0] ?? await context.newPage();
这里最常见的错误是顺手写 browser.newContext()。新建的上下文是一个干净的会话,环境里已登录的 Cookie、本地存储都不在里面,脚本会表现为"明明登录过却要求重新登录"。接管现有浏览器时,取 contexts()[0] 才是对的。
Selenium 走 debuggerAddress:
from selenium import webdriver
from selenium.webdriver.chrome.service import Service

options = webdriver.ChromeOptions()
options.add_experimental_option("debuggerAddress", f"127.0.0.1:{debug_port}")
driver = webdriver.Chrome(service=Service(webdriver_path), options=options)
注意这种模式下 Selenium 是"附着"到已有进程,不是自己拉起浏览器,所以 options 里再加启动参数(比如 --proxy-server)不会生效——代理是环境自己的配置,由客户端在启动时注入。
加一道就绪校验,能省掉一半玄学报错
启动接口返回成功,只说明客户端接受了这个指令,内核进程可能还在初始化。脚本紧接着连过去,就会遇到 ECONNREFUSED 或握手超时,而且这种失败是概率性的——机器闲时能过,批量启动时必挂。
稳妥做法是在连接前轮询 CDP 自带的版本端点,返回正常再往下走:
import time, requests

def wait_cdp(port, timeout=20):
    deadline = time.time() + timeout
    while time.time() < deadline:
        try:
            r = requests.get(f"http://127.0.0.1:{port}/json/version", timeout=1)
            if r.ok:
                return r.json()
        except requests.RequestException:
            pass
        time.sleep(0.5)
    raise TimeoutError(f"CDP {port} 未就绪")
/json/version 是 Chromium 的标准端点,返回里还带 webSocketDebuggerUrl,可以作为 ws 地址的兜底来源。
批量启动多个环境时,别一次性并发把几十个请求打出去。逐个启动、各自记录自己的端口,或者在两次启动之间留半秒到一秒间隔,客户端分配端口和拉起进程都需要时间。
收尾:一定要调停止接口
脚本结束(包括异常退出)都要调对应的停止接口把环境关掉。跳过这一步的后果是进程残留:端口被占、环境在客户端里显示为"运行中"、下次启动同一个环境直接失败。在 Python 里用 try/finally,在 Node 里用 process.on('exit') 或 try/catch 包住主流程,把 stop 请求放进去。
另外注意:脚本里调 browser.close() 的语义各框架不同,有的只是断开连接,有的会真的关掉浏览器。要让客户端正确记录环境状态、把会话数据正常落盘,还是以调客户端的停止接口为准。
连不上时按这个顺序查
- 请求 127.0.0.1 就失败:客户端没启动,或 API 服务开关没打开,或端口填错了。先在浏览器里直接访问接口地址确认。
- 接口通但启动返回错误码:环境 ID 写错、环境已在运行、或者该环境正被团队里其他成员占用。先在客户端界面上确认这个环境当前是什么状态。
- 启动成功但 ws 连不上:多半是没做就绪校验,补上
/json/version轮询。如果轮询也超时,检查是不是端口用的是上次缓存的旧值。 - 连上了但页面行为不对:Playwright 下先确认没有误建新 context;Puppeteer 下确认没有被
defaultViewport改掉视口。 - 脚本能跑但出口 IP 或时区不对:这已经不是 API 层的问题,是环境的代理配置层。按绑好代理后怎么确认出口归属和时区语言一致的顺序核一遍;如果出口显示成本机 IP,参考 WebRTC 与 UDP 通道的排查思路。
在 NexBrowser 里做这一步
NexBrowser 的 Local API 免费开放且不限调用次数,Selenium、Puppeteer、Playwright 以及 browser-use、Playwright MCP 都可以按上面的方式接管环境——也就是说想把 AI Agent 挂到某个已登录环境上,走的是同一条 CDP 通道,不需要另外买调用额度。具体的监听端口、路由路径和返回字段,以客户端设置界面和Local API 功能页给出的说明为准,不要照搬其他产品的文档。客户端目前提供 Windows 版本,macOS 还在开发中,这会影响你把脚本部署在哪台机器上。
还没装客户端的话,从下载页装好、先手动建一个环境跑通登录,再接 API——环境本身没配对,脚本连上去也只是自动化地失败一遍。
如果你要做的是多账号的重复动作而不是写代码,先看看无代码 RPA 怎么搭流程会不会更省事;已经决定用 Puppeteer 的,三种 wsEndpoint 写法那篇讲得更细。
最后提醒一句:以上都是给自有账号做隔离运营和流程自动化用的接法,任何 API 配置都不构成"不被关联"的保证,脚本行为本身也需要符合目标平台的规则。


评论(0)