 NexBrowser指纹浏览器-官方博客Blog
写自动化脚本时最容易走错的一步,是直接 puppeteer.launch() 或 chromium.launch()。这样起来的是一个干净的 Chromium 进程:没有你配好的指纹参数,没有环境绑定的代理,没有登录态,出口 IP 是本机的。看上去脚本跑通了,实际跑在一个你不想要的浏览器里。
正确做法只有一条主线:让指纹浏览器客户端把环境启动起来,脚本通过 CDP 调试地址连上去(connect),而不是自己启动(launch)。
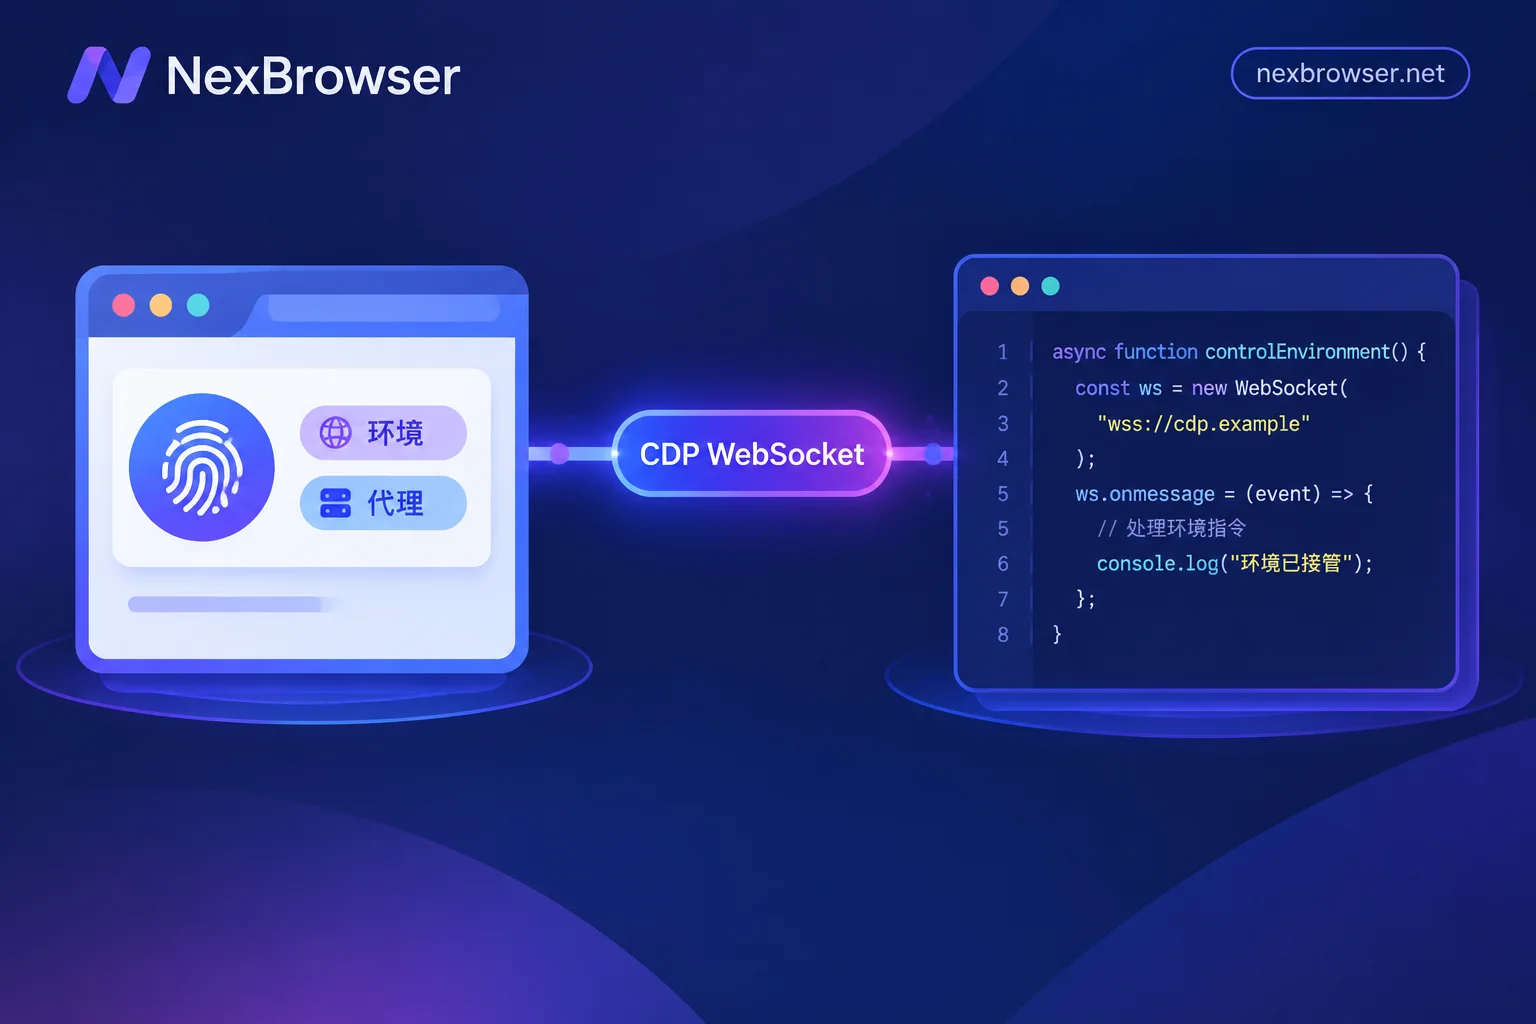
指纹浏览器大多基于 Chromium 内核,环境窗口本身就是一个开着远程调试的 Chromium 实例。Puppeteer 和 Playwright 都支持连到一个已在运行的实例上,所以接管的本质是拿到那个 WebSocket 调试地址,然后挂上去。
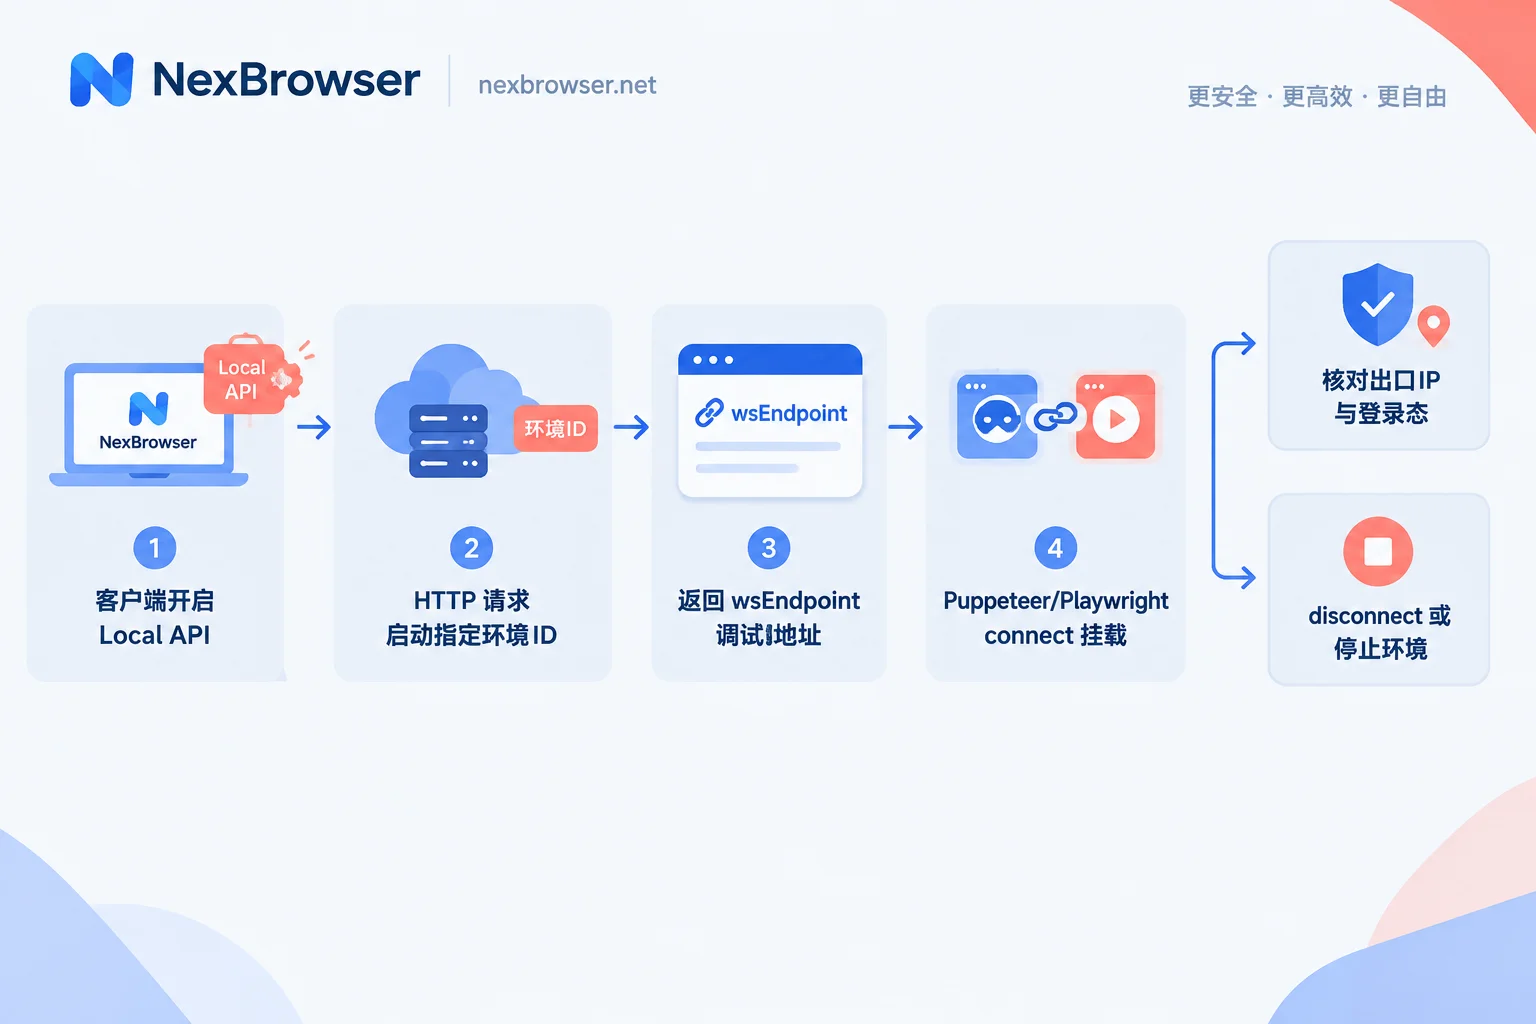
三步动作顺序
第一步:客户端保持运行,打开 Local API 服务
接管的前提是本地有一个在监听的接口服务。指纹浏览器客户端通常会在设置里提供 Local API 的开关和端口,打开后它会在本机(一般是 127.0.0.1)监听一个端口,接收启动、停止环境之类的指令。
这一步要确认两件事:客户端处于登录状态;端口没被别的程序占用。脚本连不上时,先回来看这两项,比改代码快。
第二步:用 HTTP 请求启动指定环境,从响应里取调试地址
不要让框架去启动浏览器,而是先发一个 HTTP 请求给本地接口,带上你要跑的环境 ID。接口会把这个环境的窗口拉起来,并在响应里返回该环境专属的调试地址,字段名通常是 ws、wsEndpoint 或 webSocketDebuggerUrl,形如 ws://127.0.0.1:<port>/devtools/browser/<id>。有些客户端还会一并返回一个 HTTP 形式的调试端口地址(http://127.0.0.1:<port>)。
具体的请求路径、参数名和响应结构各家不同,以你所用客户端内置的 API 文档为准,不要照抄别人博客里的路径。这一步的排查思路和字段含义,可以参考Local API 怎么启动环境并拿到调试端口。
关键点:这个地址是按环境实例生成的,每次启动可能不同,不要硬编码在脚本里。批量跑多个账号时,正确姿势是循环调用启动接口,拿到一批地址,再分别连接。
第三步:框架连上去,并复用已有的上下文和页面
拿到地址之后,两个框架的写法不一样。
Playwright(Node):
const { chromium } = require('playwright');

const browser = await chromium.connectOverCDP(wsEndpoint);

// 关键:不要 newContext(),用环境自带的默认上下文
const context = browser.contexts()[0];
const page = context.pages()[0] || await context.newPage();

await page.goto('https://example.com');
// ...
Puppeteer(Node):
const puppeteer = require('puppeteer-core');

const browser = await puppeteer.connect({
  browserWSEndpoint: wsEndpoint,
  defaultViewport: null,   // 避免框架把视口改成默认尺寸
});

const pages = await browser.pages();
const page = pages[0] || await browser.newPage();

await page.goto('https://example.com');
两个写法里各有一个容易踩的地方:
- Playwright 用
connectOverCDP挂载后,应该走browser.contexts()[0]。 CDP 挂载模式和 Playwright 自己启动浏览器的模式不完全等价,和「创建独立上下文」相关的一部分指令行为有差异。你新建一个 context,等于绕开了环境原本承载 Cookie、本地存储的那个上下文,登录态会看起来「不见了」。所有操作都放在默认上下文里做。 - Puppeteer 的
connect()默认会给页面设一个视口尺寸。 如果你发现接管后页面渲染宽高和窗口对不上,把defaultViewport设为null,让页面跟随实际窗口,这样和环境里配置的分辨率才是一致的。
Python 侧同理:Playwright 用 p.chromium.connect_over_cdp(ws),Puppeteer 生态则多用 pyppeteer 的 connect。Selenium 走的是另一条路(把调试地址作为 debuggerAddress 传进 ChromeOptions),不在本文展开。
如果你在 Puppeteer 侧遇到 ws 地址格式、端口写法上的分歧,Puppeteer 怎么连接指纹浏览器的三种 wsEndpoint 写法里有更细的对照。
在 NexBrowser 里这一步怎么做
NexBrowser 的 Local API 免费开放且不限调用次数,支持 Selenium、Puppeteer、Playwright、browser-use 以及 Playwright MCP 接管,所以你不需要为了调试一个脚本去考虑调用额度。
对接顺序和上面一致:客户端里开启 Local API → 用环境 ID 调启动接口 → 拿返回的调试地址 → connect / connectOverCDP。因为每个环境的 Cookie、缓存、本地存储和代理本来就是各自独立的,指纹参数按环境配置并保持自洽,脚本连上去之后是直接复用这一整套配置,不需要在代码里再设 UA、时区或 proxy——在代码里重设这些,反而可能和环境本身的配置打架。
接口的具体路径、端口设置与响应字段,以客户端内的 Local API 说明为准。客户端目前是 Windows 版,macOS 还在开发中。
另外一个和脚本有关的细节:环境配置支持云端加密同步,换机登录后环境还能还原,但环境 ID 与本机的调试端口是两回事——换了机器,脚本里引用的环境 ID 可以沿用,调试地址必须重新调接口获取。换机的完整动作顺序见换电脑后环境配置怎么还原。
接管之后,先做三处核对再跑业务逻辑
「连上了」不等于「接管对了」。在脚本正式执行业务动作前,建议固定加一段自检,尤其是批量任务:
- 出口 IP:导航到一个 IP 查询页,比对当前出口是否就是该环境所绑代理的出口。如果显示的是本机 IP,说明你连的很可能不是目标环境窗口,或者代理没生效。核对的层次和顺序可以参考绑好代理后怎么确认出口归属和时区语言一致。
- 指纹参数:读一下
navigator.userAgent、时区、语言,必要时看 WebRTC 的表现,确认和环境里配置的一致,而不是脚本或框架默认值覆盖了它。 - 登录态:打开一个已登录平台的页面,看会话是否仍在。如果掉登录,多半是新建了上下文,或者连到了另一个实例。
这三项都通过,才说明脚本确实跑在你配置的那个环境里。失败时的排查方向是「连错实例 / 建了新上下文 / 代理本身不通」,而不是继续调业务代码。
需要说明的是,任何配置和核验都只是把环境做到自洽,不构成不被平台关联的保证;脚本化操作也要遵守你所用平台的规则。
脚本结束时:disconnect 还是 close
这一步经常被忽略,后果是后台残留进程或数据没写回。按目的选:
- 只想释放脚本控制权、窗口继续留着人工接着用:调用
browser.disconnect()(Playwright 侧对应关闭连接而非关闭浏览器)。窗口不受影响。 - 希望脚本跑完把环境一起收掉:不要直接 kill 进程。按客户端规范调用
browser.close(),或者调 Local API 提供的「停止环境」接口。走接口停更稳妥,因为客户端会负责收尾和配置同步。
批量任务里还要注意并发数。同时拉起太多环境窗口,本机资源先撑不住,脚本超时率会直线上升;比起在代码里加重试,更实际的是分批启动、跑完即停。
几个常见状况
连接被拒绝 / ECONNREFUSED:客户端没开、没登录、Local API 没启用,或端口和脚本里写的不一致。先用浏览器或 curl 直接访问一下本地接口,确认服务在。
连上了但页面是空白新标签页:pages() 取到的是环境启动时的初始标签页,正常。直接在它上面 goto 即可,不必新开。
多环境跑串了:说明把某个环境的 wsEndpoint 复用到了别的任务上。地址和环境实例一一对应,批量时用「环境 ID → 地址 → browser 实例」的映射管理,别缓存跨轮次的地址。
只想跑固定流程、不想维护脚本:登录、点击、填表这类重复动作,其实不一定要写代码。无代码 RPA 能覆盖大部分,参考无代码 RPA 怎么搭流程;需要一次操作多个账号则看窗口同步怎么不误操作。
把顺序记住就不会跑偏:开 Local API → 按环境 ID 启动 → 取调试地址 → connect / connectOverCDP → 用默认上下文 → 三处核对 → 按需 disconnect 或停环境。 准备动手的话,从下载客户端装好并跑通第一个环境开始,再把脚本接上去。


评论(0)